डेटा माइनिंग क्या है?
डेटा माइनिंग में कई चरण शामिल होते हैं, डेटा संग्रह से लेकर विज़ुअलाइज़ेशन तक, विशाल डेटा सेट से उपयोगी जानकारी निकालने के लिए। डेटा माइनिंग तकनीकों का उपयोग लक्ष्य डेटा सेट के बारे में विवरण और भविष्यवाणियाँ उत्पन्न करने के लिए किया जाता है...
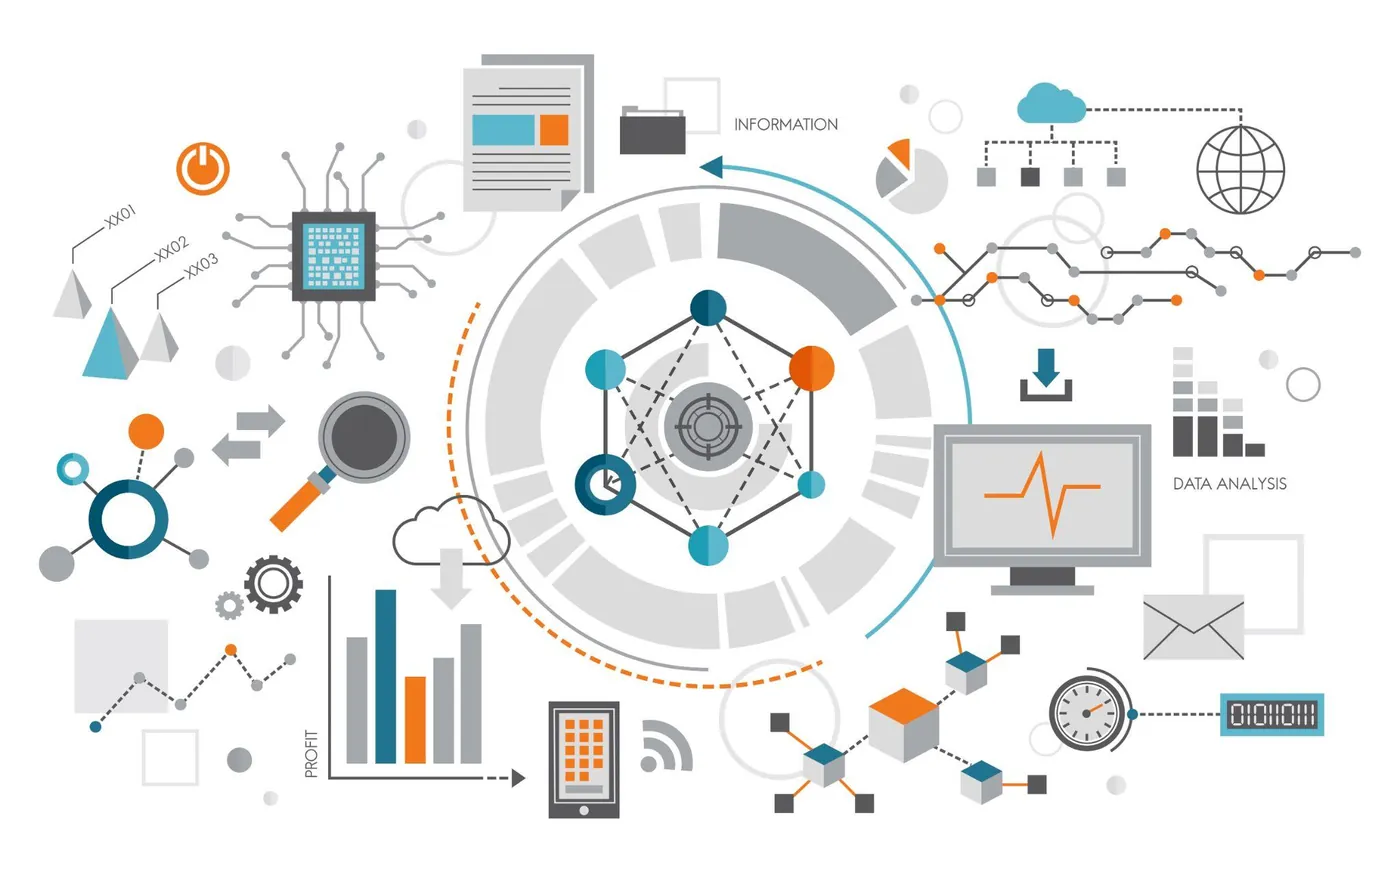
डेटा माइनिंग में कई चरण शामिल होते हैं, डेटा संग्रह से लेकर विज़ुअलाइज़ेशन तक, विशाल डेटा सेट से उपयोगी जानकारी निकालने के लिए। डेटा माइनिंग तकनीकों का उपयोग लक्ष्य डेटा सेट के बारे में विवरण और भविष्यवाणियाँ उत्पन्न करने के लिए किया जाता है, जैसा कि ऊपर चर्चा की गई है। डेटा वैज्ञानिक डेटा का वर्णन करने के लिए पैटर्न, कनेक्शन और सहसंबंधों का उपयोग करते हैं। वे डेटा को वर्गीकृत और क्लस्टर करने के लिए वर्गीकरण और प्रतिगमन एल्गोरिदम का भी उपयोग करते हैं, साथ ही स्पैम डिटेक्शन जैसे उपयोग मामलों के लिए आउटलायर की पहचान करते हैं।
उद्देश्य निर्धारित करना, डेटा एकत्र करना और तैयार करना, डेटा माइनिंग एल्गोरिदम लागू करना, और परिणामों का मूल्यांकन करना, ये डेटा माइनिंग के चार प्रमुख चरण हैं।
1. उद्देश्य निर्धारित करना:
यह डेटा माइनिंग प्रक्रिया का सबसे कठिन तत्व हो सकता है, और कई कंपनियाँ इस महत्वपूर्ण चरण को अनदेखा कर देती हैं। डेटा वैज्ञानिकों और व्यावसायिक हितधारकों को व्यावसायिक चुनौती स्थापित करने के लिए सहयोग करना होगा, जो किसी विशिष्ट परियोजना के लिए डेटा प्रश्नों और मापदंडों का मार्गदर्शन करेगी। विश्लेषकों को व्यावसायिक संदर्भ को पूरी तरह से समझने के लिए अतिरिक्त अध्ययन करने की आवश्यकता हो सकती है।
2. डेटा संग्रह और तैयारी:
एक बार समस्या का दायरा निर्धारित हो जाने के बाद, डेटा वैज्ञानिक अधिक आसानी से यह निर्धारित कर सकते हैं कि कौन सा डेटा संग्रह उन्हें आवश्यक व्यावसायिक प्रश्नों का उत्तर देने में मदद करेगा। वे डेटा एकत्र करने के बाद उसे साफ करेंगे, डुप्लीकेट, लापता संख्याओं और आउटलायर जैसे किसी भी शोर को हटा देंगे। डेटासेट के आधार पर, डायमेंशन की संख्या को कम करने के लिए एक अतिरिक्त चरण की आवश्यकता हो सकती है, क्योंकि बहुत अधिक फीचर किसी भी बाद की गणना को धीमा कर सकती हैं। किसी भी मॉडल में इष्टतम सटीकता सुनिश्चित करने के लिए, डेटा वैज्ञानिक सबसे महत्वपूर्ण भविष्यवक्ताओं को बनाए रखने का प्रयास करेंगे।
3. डेटा माइनिंग एल्गोरिदम लागू करना:
डेटा वैज्ञानिक अनुसंधान के प्रकार के आधार पर, किसी भी दिलचस्प डेटा लिंकेज, जैसे अनुक्रमिक पैटर्न, एसोसिएशन नियम, या सहसंबंध को देख सकते हैं। जबकि उच्च आवृत्ति पैटर्न उपयोगों की एक विस्तृत श्रृंखला प्रदान करते हैं, डेटा भिन्नताएं कभी-कभी अधिक आकर्षक हो सकती हैं, जो संभावित धोखाधड़ी क्षेत्रों को उजागर करती हैं।
4. परिणामों का मूल्यांकन:
डेटा एकत्र होने के बाद, परिणामों की जांच और समझ आवश्यक है। जब परिणामों को अंतिम रूप देने की बात आती है, तो वे वैध, अद्वितीय, मूल्यवान और समझने में आसान होने चाहिए। जब यह मानदंड पूरा होता है, तो संगठन इस जानकारी का उपयोग नई रणनीतियों को विकसित करने के लिए कर सकते हैं जो उन्हें अपने लक्ष्यों को प्राप्त करने में मदद करेंगी।
डेटा माइनिंग का उपयोग: टेलीकॉम, मीडिया और प्रौद्योगिकी
कड़ी प्रतिस्पर्धा वाले भीड़ भरे बाजार में, उत्तर अक्सर आपके ग्राहक डेटा में पाए जाते हैं। विश्लेषणात्मक मॉडल टेलीकॉम, मीडिया और प्रौद्योगिकी फर्मों को बड़े क्लाइंट डेटा सेट को समझने में मदद कर सकते हैं, जिससे वे ग्राहक व्यवहार की भविष्यवाणी कर सकती हैं और अत्यधिक लक्षित और प्रासंगिक विज्ञापन प्रदान कर सकती हैं।
विनिर्माण क्षेत्र
समस्याओं का प्रारंभिक निदान, गुणवत्ता आश्वासन, और ब्रांड इक्विटी निवेश सभी महत्वपूर्ण हैं, जैसे कि मांग अनुमानों के साथ आपूर्ति योजनाओं को संरेखित करना। निर्माता टूट-फूट और उत्पादन उपकरणों के रखरखाव की भविष्यवाणी कर सकते हैं, जिससे वे अपटाइम को अधिकतम कर सकते हैं और उत्पादन लाइन को शेड्यूल पर रख सकते हैं।
शिक्षा
शिक्षक छात्र विकास के एकीकृत, डेटा-संचालित दृष्टिकोण का उपयोग करके कक्षा में प्रवेश करने से पहले छात्रों के प्रदर्शन का पूर्वानुमान लगा सकते हैं, और उन्हें ट्रैक पर रखने के लिए हस्तक्षेप तकनीकों की योजना बना सकते हैं। डेटा माइनिंग शिक्षकों को अनुमति देता है छात्र डेटा तक पहुंचने, सफलता स्तरों का अनुमान लगाने और उन बच्चों या छात्रों के समूहों की पहचान करने के लिए जिन्हें अतिरिक्त सहायता की आवश्यकता है।
बीमा
बीमा कंपनियाँ धोखाधड़ी, अनुपालन, जोखिम प्रबंधन, और ग्राहक अपघर्षण जैसी कठिन चुनौतियों को विश्लेषणात्मक विशेषज्ञता के साथ संभाल सकती हैं। कंपनियों ने कंपनी लाइनों में उत्पादों की बेहतर कीमत निर्धारित करने और अपने मौजूदा उपभोक्ता आधार को प्रतिस्पर्धी उत्पाद प्रदान करने के नए तरीके खोजने के लिए डेटा माइनिंग तकनीकों का उपयोग किया है।
बैंकिंग
बैंक अपने ग्राहक आधार और वित्तीय प्रणाली बनाने वाले अरबों लेनदेन को बेहतर ढंग से समझने के लिए स्वचालित एल्गोरिदम का उपयोग कर सकते हैं। वित्तीय सेवा व्यवसाय बाजार जोखिमों को बेहतर ढंग से समझने, तेजी से धोखाधड़ी का पता लगाने, नियामक अनुपालन कर्तव्यों का प्रबंधन करने और अपने मार्केटिंग खर्च पर रिटर्न को अधिकतम करने के लिए डेटा माइनिंग का उपयोग कर सकते हैं।
खुदरा
क्योंकि यह बिक्री, ग्राहक खरीद इतिहास, उत्पाद परिवहन, खपत और सेवाओं से बड़ी मात्रा में डेटा एकत्र करता है, इसलिए खुदरा उद्योग में डेटा माइनिंग के कई अनुप्रयोग हैं। इंटरनेट की बढ़ती सुविधा, उपलब्धता और लोकप्रियता के कारण, यह तार्किक है कि एकत्र किए गए डेटा की मात्रा काफी बढ़ती रहेगी। बड़े ग्राहक डेटाबेस छिपी हुई ग्राहक बुद्धिमत्ता को प्रकट करके कनेक्शन बढ़ाने, मार्केटिंग अभियानों को अनुकूलित करने और बिक्री का अनुमान लगाने में आपकी मदद कर सकते हैं। अधिक सटीक डेटा मॉडल के लिए धन्यवाद, खुदरा विक्रेता अधिक केंद्रित मार्केटिंग प्रदान कर सकते हैं – और उस ऑफर का पता लगा सकते हैं जिसका ग्राहकों पर सबसे अधिक प्रभाव पड़ता है।
डेटा माइनिंग तकनीकें
डेटा माइनिंग विशेष रूप से प्रभावी होती है जब यह निम्नलिखित तकनीकों में से एक या अधिक का उपयोग करती है:
1. पैटर्न ट्रैकिंग
पैटर्न देखना। अपने डेटा सेट में पैटर्न खोजना सीखना सबसे बुनियादी डेटा माइनिंग दृष्टिकोणों में से एक है। यह अक्सर आपके डेटा में एक आवधिक विचलन की पहचान या समय के साथ किसी विशेष चर का उतार-चढ़ाव होता है। उदाहरण के लिए, आप पा सकते हैं कि किसी विशेष उत्पाद की बिक्री त्योहारों से ठीक पहले बढ़ जाती है, या कि गर्म मौसम आपकी वेबसाइट पर अधिक आगंतुकों को आकर्षित करता है।
2. वर्गीकरण
वर्गीकरण एक अधिक उन्नत डेटा माइनिंग तकनीक है जिसके लिए आपको विभिन्न विशेषताओं को पहचानने योग्य समूहों में समूहीकृत करने की आवश्यकता होती है, जिनका उपयोग आप अतिरिक्त निष्कर्ष निकालने या एक विशिष्ट कार्य करने के लिए कर सकते हैं। यहीं पर Klassifier बहुत काम आता है। Klassifier अंतर्दृष्टि प्राप्त करने के लिए पाठ और डेटा को वर्गीकृत करने में मदद करता है। आप अपनी वित्तीय पृष्ठभूमि और खरीद इतिहास के बारे में डेटा के आधार पर व्यक्तिगत उपभोक्ताओं को 'निम्न', 'मध्यम' या 'उच्च' ऋण जोखिम के रूप में नामित करने में सक्षम हो सकते हैं। इन वर्गीकरणों का उपयोग उन ग्राहकों के बारे में और भी अधिक जानने के लिए किया जा सकता है।
3. भविष्यवाणी
क्योंकि इसका उपयोग भविष्य में दिखाई देने वाले डेटा के प्रकारों की भविष्यवाणी करने के लिए किया जाता है, भविष्यवाणी सबसे महत्वपूर्ण डेटा माइनिंग दृष्टिकोणों में से एक है। कई परिस्थितियों में, पिछली प्रवृत्तियों को नोटिस करना और समझना ही भविष्य में क्या होगा इसका उचित पूर्वानुमान प्रदान करने के लिए पर्याप्त है। उदाहरण के लिए, आप किसी उपभोक्ता के क्रेडिट इतिहास और पिछले लेनदेन को देख सकते हैं कि क्या वे भविष्य में क्रेडिट जोखिम हैं।
4. आउटलायर डिटेक्शन
एनोमली डिटेक्शन (जिसे आउटलायर डिटेक्शन के रूप में भी जाना जाता है) असामान्य चीजों, घटनाओं या अवलोकनों की पहचान करने की प्रक्रिया है जो बाकी डेटा से बहुत अधिक विचलित होकर संदेह उत्पन्न करती हैं। दो प्रकार के आउटलायर हैं: यूनिवेरिएट और मल्टीवेरिएट। एकल फीचर स्पेस में मानों के वितरण को देखते समय यूनिवेरिएट आउटलायर का पता लगाया जा सकता है। n-आयामी स्थान में, मल्टीवेरिएट आउटलायर का पता लगाया जा सकता है (n-फीचर का)। मानव मस्तिष्क n-आयामी स्पेस में वितरण देखने में संघर्ष करता है, यही कारण है कि हमें इसे हमारे लिए करने के लिए एक मॉडल को प्रशिक्षित करने की आवश्यकता है।
Klassifier और डेटा माइनिंग
डेटा माइनिंग वर्तमान स्थिति में बहुत महत्वपूर्ण हो गई है। तकनीकी दुनिया ने कब्जा कर लिया है और Klassifier के साथ, आप भी इस दुनिया का हिस्सा बन सकते हैं। गुणात्मक डेटा का विश्लेषण करने में हम आपकी सहायता कर सकते हैं। Klassifier एक ऑनलाइन टेक्स्ट-विश्लेषण प्लेटफ़ॉर्म है जिसमें सरल AI सुविधाएँ हैं जो आपको अभी गुणात्मक डेटा के साथ शुरुआत करने में मदद करेंगी। स्वचालित सुविधाओं और मशीन लर्निंग के साथ, आप जो चाहें विश्लेषण कर सकते हैं। दोहराव वाले कार्यों को हम पर छोड़ें और अपना काम आसान बनाने के लिए आज हमारे साथ एक मॉडल बनाएं और उत्पाद फीडबैक डेटा से अधिकतम लाभ उठाएं।
आज साइन अप करें या निःशुल्क डेमो बुक करें Klassifier के साथ अधिक जानने के लिए।