Was ist Datenvorbereitung?
Das Sortieren, Bereinigen und Strukturieren von Rohdaten, damit sie in Business Intelligence, Analysen und maschinellen Lernanwendungen effektiver genutzt werden können, wird als Datenvorbereitung bezeichnet...
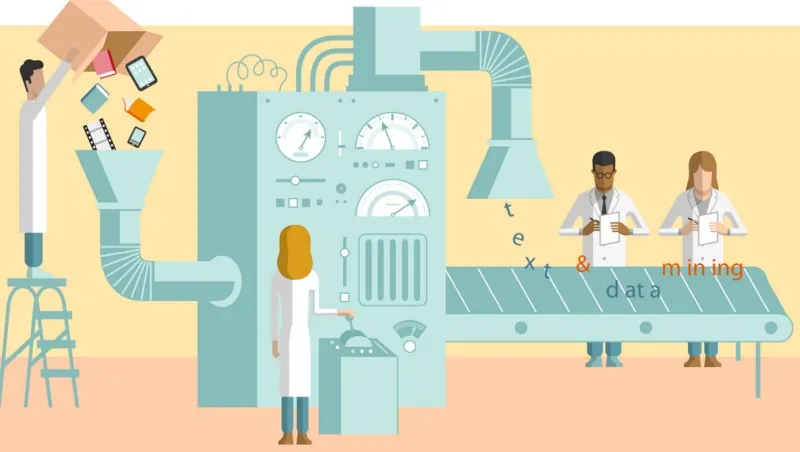
Das Sortieren, Bereinigen und Strukturieren von Rohdaten, damit sie in Business Intelligence, Analysen und maschinellen Lernanwendungen effektiver genutzt werden können, wird als Datenvorbereitung bezeichnet.
Daten gibt es in verschiedenen Formaten, aber für dieses Tutorial konzentrieren wir uns auf die zwei häufigsten Datentyen: Text- und numerische Daten.
Die Aufbereitung von Textdaten eliminiert grammatikalische und kontextspezifische Textfehler, sodass umfangreiche Textarchive tabellarisch erfasst und nach relevanten Erkenntnissen durchsucht werden können.
Die Standardisierung numerischer Daten ist eine gängige Praxis. Wenn Kundendaten eingingen, bei denen Prozentwerte sowohl als Prozentsätze (55 Prozent, 80 Prozent) als auch als Dezimalzahlen (.55, .80) übermittelt wurden, würde eine intelligente Datenvorbereitung – wie ein kluger Mathematiker – erkennen, dass diese Zahlen dasselbe ausdrücken, und sie in einem einheitlichen Format standardisieren.
Da sich Sätze und die sie bildenden Wörter mit Sprache, Kontext und Format ändern, neigen Texte dazu, unstrukturiert zu sein (eine E-Mail vs. ein Chat-Protokoll vs. eine Online-Bewertung). Daher ist es vorteilhaft, unsere Textdaten zu „bereinigen", indem wir wiederholte Begriffe entfernen und Bedeutungen standardisieren, während wir unsere Textdaten erstellen.
Da die meisten Algorithmen des maschinellen Lernens erfordern, dass Daten auf eine bestimmte Weise strukturiert sind, erfordern Datensätze fast immer eine gewisse Vorverarbeitung, bevor sie wertvolle Erkenntnisse liefern können. Einige Datensätze enthalten Werte, die entweder fehlen, ungültig oder anderweitig schwer von einem Algorithmus zu verarbeiten sind. Der Algorithmus kann fehlende Daten nicht verwenden. Wenn die Daten falsch sind, liefert der Algorithmus weniger genaue oder sogar falsche Ergebnisse. Einige Datensätze sind relativ sauber, erfordern aber eine Formgebung (z. B. aggregiert oder rotiert), während anderen einfach ein sinnvoller Geschäftskontext fehlt (z. B. schlecht definierte ID-Werte), was eine Feature-Anreicherung erforderlich macht. Saubere und gut gepflegte Daten entstehen durch eine gute Datenvorbereitung, was zu praktischeren und genaueren Modellausgaben führt.
Schritte der Datenvorbereitung
Es gibt fünf Schritte, die bei der Vorbereitung von Daten berücksichtigt werden sollten.
1. Daten sammeln
Das Finden der richtigen Daten ist der erste Schritt im Datenvorbereitungsprozess. Diese können aus einem vorhandenen Datenkatalog entnommen oder spontan hinzugefügt werden.
2. Daten bewerten und entdecken
Sie können Ihre Datenvorbereitungstechniken nur verbessern, wenn Sie wissen, womit Sie arbeiten. Die Ausgaben für Datenentdeckungstools sind schneller gestiegen als die Investitionen in Standard-IT-Lösungen, was darauf hindeutet, dass sie zu einer Top-Ausgabepriorität geworden sind. Ihre Daten zu entdecken bedeutet einfach, sie besser kennenzulernen. 'Was kann ich aus meinen Daten gewinnen und lernen?' und 'Wie erhebe ich sie?' sind Beispiele für relevante Fragen. Sicherzustellen, dass Sie die richtige Datenerfassungsmethode verwenden, ist entscheidend für eine erfolgreiche Datenanalyse.
3. Daten bereinigen und validieren
Dies ist der wichtigste Schritt der Datenvorbereitung. Die Daten, die Sie verwenden möchten, sollten direkt und fehlerfrei sein, damit Klassifier Ihnen die bestmöglichen Ergebnisse liefert und Ihre Anfragen mit einer besseren Erfolgsrate löst.
Dies beinhaltet die Standardisierung der Daten, was bedeutet, sicherzustellen, dass das Format verständlich ist, irrelevante/unnötige Informationen zu entfernen und eventuelle Lücken zu füllen. Hier kommt Datenvorbereitungssoftware zum Einsatz, da sie Ineffizienzen aufdecken und falsche Formatierungen korrigieren kann.
4. Datenanreicherung
Hier zählt die Methode, die Sie zur Vorbereitung Ihrer Daten verwenden, am meisten. Sie können Ihre Daten nun anreichern (d. h. verbessern), indem Sie alles hinzufügen, was fehlt, basierend auf den nun besser definierten Zielen, zu denen Sie in der Entdeckungsphase gelangt sind.
Datentransformation bedeutet, das Format oder die Werteeingaben zu ändern, um ein bestimmtes Ergebnis zu erzielen oder die Daten für ein breiteres Publikum verständlicher zu machen. Das Hinzufügen und Verknüpfen von Daten mit anderen verwandten Informationen, um tiefere Einblicke zu bieten, wird als Datenanreicherung bezeichnet.
Unser manuelles Trainingfeature hilft Ihnen, jederzeit Eingaben hinzuzufügen und den Klassifier-Bot zu trainieren, wann immer informativere Daten mit dem Klassifizierungsprozess verknüpft werden müssen.
5. Daten speichern
Es ist an der Zeit, Ihre sauberen, nützlichen Daten zu speichern. Wir empfehlen die Wahl einer zukunftssicheren cloudbasierten Speicherlösung, damit Sie Ihre Datenvorbereitungsparameter bei Bedarf für zukünftige Analysen anpassen können.
Die Datenvorbereitung kann für die gewünschten Ergebnisse aus bestimmten Daten mühsam sein, aber mit den richtigen Tools lässt sich der gesamte Prozess für Datenwissenschaftler auf eine einfache Aufgabe reduzieren. Die Wahl der besten Tools ist für die Datenvorbereitung sehr wichtig, und die Wahl des richtigen Klassifikators, um das Beste aus den Daten herauszuholen, ist ebenfalls entscheidend. Daher empfehlen wir Ihnen, Ihre Klassifizierung von Klassifier durchführen zu lassen, wenn Sie mit der Datenvorbereitung fertig sind.
Heute registrieren Oder Kostenlose Demo buchen Mit Klassifier, um mehr zu erfahren.