Wat is datavoorbereiding?
Het sorteren, opschonen en structureren van ruwe data zodat deze effectiever kan worden gebruikt in business intelligence, analyses en machine learning-toepassingen, staat bekend als datavoorbereiding...
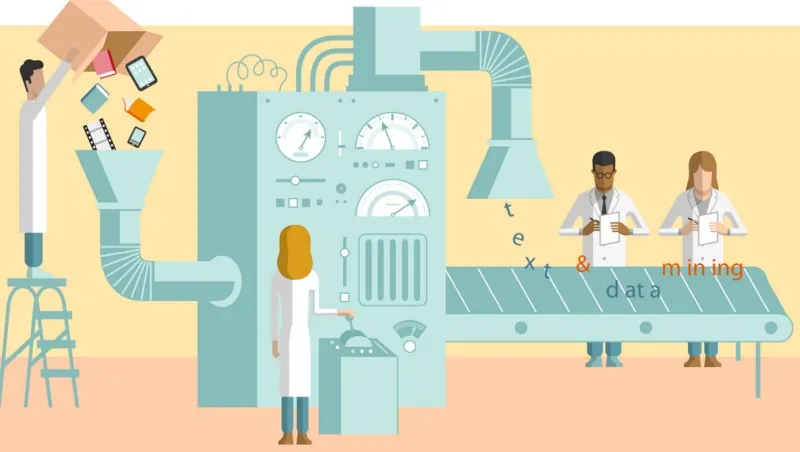
Het sorteren, opschonen en structureren van ruwe data zodat deze effectiever kan worden gebruikt in business intelligence, analyses en machine learning-toepassingen, staat bekend als datavoorbereiding.
Data is beschikbaar in verschillende formaten, maar voor dit tutorial concentreren we ons op de twee meest voorkomende soorten: tekstuele en numerieke data.
Voorbereiding van tekstdata elimineert grammaticale en contextspecifieke tekstfouten, waardoor grote tekstarchieven kunnen worden getabuleerd en doorzocht op relevante inzichten.
De standaardisatie van numerieke data is een veelgebruikte praktijk. Als klantdata binnenkwam waarbij percentages zowel als procenten (55 procent, 80 procent) als decimale bedragen (.55, .80) werden ingediend, zou slimme datavoorbereiding, net als een slimme wiskundige, kunnen herkennen dat deze getallen hetzelfde uitdrukken en ze naar één formaat standaardiseren.
Omdat zinnen en de woorden die ze vormen veranderen met taal, context en formaat, heeft tekst de neiging lawaaierig te zijn (een e-mail vs. een chattranscript vs. een online recensie). Daarom is het voordelig om onze tekstdata te 'reinigen' door herhaalde termen te elimineren en betekenis te standaardiseren terwijl we onze tekstdata produceren.
Omdat de meeste machine learning-algoritmen vereisen dat data op een bepaalde manier is gestructureerd, zullen datasets vrijwel altijd enige voorverwerking nodig hebben voordat ze waardevolle inzichten kunnen bieden. Sommige datasets bevatten waarden die ontbreken, ongeldig zijn of anderszins moeilijk te verwerken zijn door een algoritme. Het algoritme kan geen ontbrekende data gebruiken. Als de data onjuist is, zal het algoritme minder nauwkeurige of zelfs onjuiste resultaten geven. Sommige datasets zijn redelijk schoon maar vereisen opmaak (bijv. geaggregeerd of geroteerd), terwijl andere eenvoudigweg zinvolle bedrijfscontext missen (bijv. slecht gedefinieerde ID-waarden), waardoor feature-verrijking noodzakelijk wordt. Schone en goed gecureerde data wordt geproduceerd door goede datavoorbereiding, wat leidt tot meer praktische en nauwkeurige modeluitvoer.
Stappen van datavoorbereiding
Er zijn vijf stappen die in overweging moeten worden genomen bij het voorbereiden van data.
1. Data verzamelen
De juiste data vinden is de eerste stap in het datavoobereidingsproces. Dit kan worden gehaald uit een bestaande datacatalogus of onderweg worden toegevoegd.
2. Data beoordelen en ontdekken
Je kunt je datavoobereidingstechnieken alleen verbeteren als je weet waarmee je werkt. De uitgaven aan data-ontdekkingstools zijn sneller gestegen dan de investeringen in standaard IT-oplossingen, wat aangeeft dat het een topprioriteit voor uitgaven is geworden. Je data ontdekken betekent gewoon beter kennis maken. 'Wat kan ik uit mijn data halen en leren?' en 'Hoe verzamel ik het?' zijn voorbeelden van relevante vragen. Ervoor zorgen dat je de juiste methode voor gegevensverzameling gebruikt, is cruciaal voor een succesvolle data-analyse.
3. Je data reinigen en valideren
Dit is de belangrijkste stap van datavoorbereiding. De data die je wilt gebruiken moet direct en foutloos zijn zodat Klassifier je de best mogelijke resultaten geeft en je vragen met een betere slagingspercentage oplost.
Dit houdt in het standaardiseren van de data, wat inhoudt dat het formaat begrijpelijk is, overbodige/onnodige informatie wordt verwijderd en eventuele hiaten worden gevuld. Dit is waar datavoorbereidingssoftware van pas komt, omdat het inefficiënties kan ontdekken en onjuiste opmaak kan corrigeren.
4. Data verrijken
Hier telt de methode die je gebruikt om je data voor te bereiden het meest. Je kunt je data nu verrijken (d.w.z. verbeteren) door alles toe te voegen wat je mist, op basis van de nu beter gedefinieerde doelstellingen die je in de ontdekkingsfase hebt bereikt.
Het transformeren van data is het wijzigen van het formaat of de waardenинвут om een bepaald resultaat te bereiken of de data begrijpelijker te maken voor een breder publiek. Het toevoegen en verknopen van data met andere gerelateerde informatie om diepere inzichten te bieden, wordt data verrijking genoemd.
Onze handmatige trainingsfunctie helpt je om inputs toe te voegen wanneer je wilt en de Klassifier-bot te trainen wanneer er behoefte is om meer informatieve data aan het classificatieproces te koppelen.
5. Je data opslaan
Het is tijd om je schone, nuttige data op te slaan. We stellen voor om een toekomstbestendige cloudgebaseerde opslagoplossing te selecteren zodat je je datavoobereidingsparameters naar behoefte kunt aanpassen voor toekomstige analyses.
Datavoorbereiding kan lastig zijn voor de resultaten die je uit specifieke data wilt halen, maar met de juiste tools kan het hele proces worden teruggebracht tot een eenvoudige taak voor data scientists. Het kiezen van de beste tools is erg belangrijk voor datavoorbereiding, en het kiezen van de juiste classificator om het beste uit de data te halen is ook cruciaal. Daarom raden we je aan om je classificatie door Klassifier te laten uitvoeren zodra je klaar bent met het voorbereiden van data.
Meld je vandaag aan Of Boek een gratis demo Met Klassifier om meer te leren.