Czym jest przygotowanie danych?
Sortowanie, czyszczenie i strukturyzowanie surowych danych w taki sposób, aby można je było skuteczniej wykorzystywać w analizie biznesowej, analityce i aplikacjach uczenia maszynowego, jest znane jako przygotowanie danych...
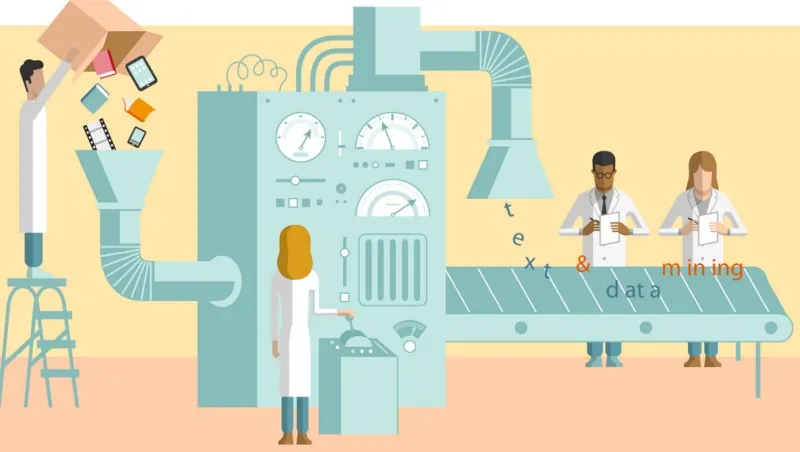
Sortowanie, czyszczenie i strukturyzowanie surowych danych w taki sposób, aby można je było skuteczniej wykorzystywać w analizie biznesowej, analityce i aplikacjach uczenia maszynowego, jest znane jako przygotowanie danych.
Dane występują w różnych formatach, ale na potrzeby tego samouczka skupimy się na dwóch najpowszechniejszych typach danych: tekstowych i numerycznych.
Przygotowanie danych tekstowych eliminuje błędy gramatyczne i kontekstowe, umożliwiając tabelaryzację i przeszukiwanie rozległych archiwów tekstowych w celu wydobycia istotnych spostrzeżeń.
Standaryzacja danych numerycznych jest powszechną praktyką. Gdyby dane klientów zawierały wartości procentowe przesyłane zarówno jako procenty (55 procent, 80 procent), jak i liczby dziesiętne (.55, .80), inteligentne przygotowanie danych, niczym sprawny matematyk, potrafiłoby rozpoznać, że liczby te wyrażają to samo, i ujednolicyłoby je do jednego formatu.
Ponieważ zdania i tworzące je słowa zmieniają się wraz z językiem, kontekstem i formatem, teksty mają tendencję do bycia „zaszumionymi" (wiadomość e-mail kontra dziennik czatu kontra recenzja online). Dlatego korzystne jest „czyszczenie" danych tekstowych poprzez eliminację powtarzających się terminów i standaryzację znaczeń podczas ich przetwarzania.
Ponieważ większość algorytmów uczenia maszynowego wymaga, aby dane były ustrukturyzowane w określony sposób, zestawy danych będą niemal zawsze wymagać wstępnego przetworzenia, zanim będą mogły dostarczyć cennych spostrzeżeń. Niektóre zestawy danych zawierają wartości, które są brakujące, nieprawidłowe lub w inny sposób trudne do przetworzenia przez algorytm. Algorytm nie może używać brakujących danych. Jeśli dane są nieprawidłowe, algorytm dostarczy mniej dokładnych lub nawet błędnych wyników. Niektóre zestawy danych są stosunkowo czyste, ale wymagają kształtowania (np. agregacji lub rotacji), podczas gdy innym brakuje znaczącego kontekstu biznesowego (np. słabo zdefiniowanych wartości ID), co wymaga wzbogacania cech. Czyste i dobrze wyselekcjonowane dane są wytwarzane przez dobre przygotowanie danych, co prowadzi do bardziej praktycznych i dokładnych wyników modeli.
Etapy przygotowania danych
Podczas przygotowywania danych należy wziąć pod uwagę pięć kroków.
1. Zebranie danych
Znalezienie właściwych danych jest pierwszym krokiem w procesie przygotowania danych. Mogą one zostać pobrane z istniejącego katalogu danych lub dodane na bieżąco.
2. Ocena i odkrywanie danych
Możesz udoskonalać techniki przygotowania danych tylko wtedy, gdy wiesz, z czym pracujesz. Wydatki na narzędzia do odkrywania danych rosły szybciej niż inwestycje w standardowe rozwiązania IT, co wskazuje, że stały się one priorytetem wydatkowym. Odkrywanie danych oznacza po prostu lepsze ich poznanie. „Co mogę uzyskać i czego mogę się nauczyć z moich danych?" oraz „jak je zbieram?" to przykłady istotnych pytań. Upewnienie się, że używasz właściwej metody zbierania danych, ma kluczowe znaczenie dla pomyślnej analizy danych.
3. Czyszczenie i walidacja danych
Jest to najważniejszy krok przygotowania danych. Dane, których chcesz używać, powinny być bezpośrednie i wolne od błędów, aby Klassifier dawał Ci jak najlepsze wyniki i rozwiązywał Twoje zapytania z wyższym wskaźnikiem sukcesu.
Wiąże się to ze standaryzacją danych, czyli zapewnieniem zrozumiałości formatu, usunięciem zbędnych/niepotrzebnych informacji i wypełnieniem wszelkich luk. Tutaj z pomocą przychodzi oprogramowanie do przygotowania danych, które może wykrywać nieefektywności i naprawiać nieprawidłowe formatowanie.
4. Wzbogacanie danych
W tym miejscu najbardziej liczy się metoda, której używasz do przygotowania danych. Możesz teraz wzbogacić (czyli ulepszyć) swoje dane, dodając to, czego brakuje, na podstawie celów wyraźniej zdefiniowanych na etapie odkrywania.
Transformacja danych polega na zmianie formatu lub wprowadzanych wartości w celu osiągnięcia określonego rezultatu lub uczynienia danych bardziej zrozumiałymi dla szerszego grona odbiorców. Dodawanie i łączenie danych z innymi powiązanymi informacjami w celu oferowania głębszych spostrzeżeń określa się mianem wzbogacania danych.
Nasza funkcja ręcznego trenowania pomaga dodawać dane wejściowe w dowolnym momencie i trenować bota Klassifier zawsze, gdy zachodzi potrzeba powiązania bardziej informatywnych danych z procesem klasyfikacji.
5. Przechowywanie danych
Czas przechować czyste, użyteczne dane. Proponujemy wybranie przyszłościowego rozwiązania do przechowywania w chmurze, aby móc dostosowywać parametry przygotowania danych do przyszłych analiz w razie potrzeby.
Przygotowanie danych może być uciążliwe ze względu na wyniki, jakie chcesz uzyskać z konkretnych danych, ale przy odpowiednich narzędziach cały proces można sprowadzić do prostego zadania dla naukowców zajmujących się danymi. Wybór najlepszych narzędzi jest bardzo ważny dla przygotowania danych, a wybór odpowiedniego klasyfikatora, aby wyciągnąć jak najwięcej z danych, jest również kluczowy. Dlatego zalecamy przeprowadzenie klasyfikacji za pomocą Klassifiera po zakończeniu przygotowywania danych.
Zarejestruj się dzisiaj Lub Zarezerwuj bezpłatne demo Z Klassifier, aby dowiedzieć się więcej.