自動機械学習を使用すべき理由とは?
機械学習は、データを処理して正確な予測を行うモデルを構築するために、さまざまな手法とアルゴリズムを使用します。それには...
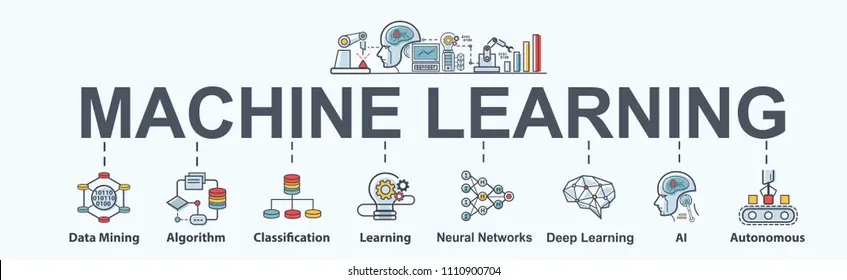
機械学習は、データを処理して正確な予測を行うモデルを構築するために、さまざまな手法とアルゴリズムを使用します。
機械学習モデルを手動で構築するには、機械学習アルゴリズムの知識とコンピューターサイエンスのスキルが必要であり、これにより非技術系ユーザーにとっての使いやすさと機能性が低下します。
機械学習モデルを手動で構築できる専門家や有資格者でさえ、非常に時間とエネルギーを消費し、タスクを完了して望ましい結果を達成するためにすべてのステップを経なければなりません。
このプロセスは人間に依存しており、繰り返し作業です。機械学習の専門家は、モデルを構築するためにデータのクリーニング、前処理、準備に多くの時間を費やさなければなりません。また、人的ミスや偏りも発生する可能性があり、モデルの不正確さを招きます。
以下は、機械学習モデル構築プロセスの簡略化されたステップです:
- データを収集する
- データを前処理する
- データから特徴を抽出する
- モデルをトレーニングする
- モデルをテストして検証する
- モデルをデプロイする
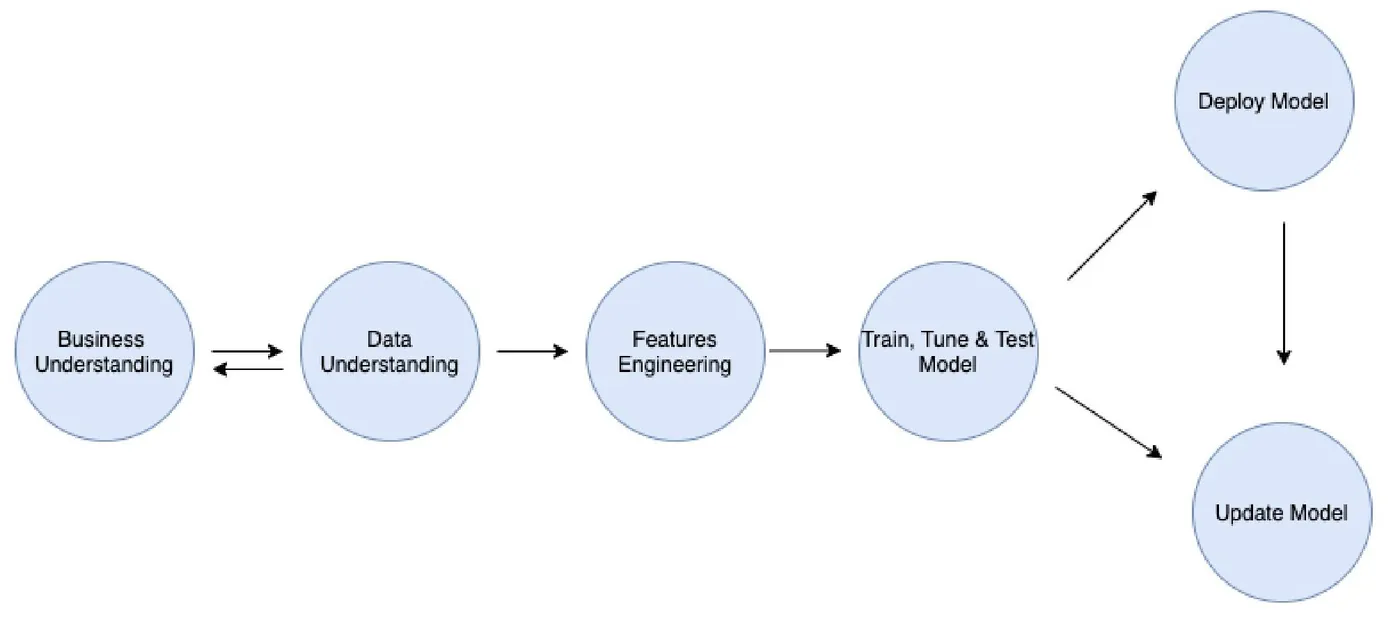
しかし、自動機械学習は、これらのステップを自動化することで、機械学習モデルを簡単に実装し、解決策に到達することを可能にします。
自動機械学習は誰でも利用できます。独自の分類モデルを構築するために、データサイエンティストや機械学習の専門家である必要はありません。
自動機械学習の仕組み:データをアップロードすると、自動機械学習がさまざまな機械学習モデルとアルゴリズムをテストし、最もよく機能する機械学習モデルを選択して、そのパフォーマンスを監視します。
自動機械学習を使用することで、精度を確信することができます。自動機械学習は、人的ミスや偏りによって引き起こされるモデルの不正確さの可能性を低減し、より優れた分類モデルにつながり、より高い精度を達成するためです。
自動機械学習は、プロセス全体をシンプルかつ自動化します。
- 多くの時間と労力を節約できる
- 機械学習を手軽に利用できるようにする
- 専門知識や機械学習の知識がない人でも簡単に使用できる
- 人的ミスや偏りがない
自動機械学習のユースケース:
分類問題
分類問題では、固定された数のクラスやラベルからデータに割り当てるべきラベルを予測する分類モデルを構築したいと考えます。
一般的な分類の例には、物体検出、手書き認識、不正検出などがあります。
回帰問題
回帰モデルは数値を予測します。非常に一般的な例として、販売価格予測や住宅価格予測があります。
特徴選択
機械学習アルゴリズムが特徴を正しく選択しない場合、モデルの精度だけでなく構築時間にも大きな影響を与えます。しかし、自動機械学習を使用することで、特徴選択がより効率的に行われます。
アルゴリズム選択
最適なアルゴリズムを見つけ、最高の精度を提供する最良のモデリングアルゴリズムを選択するプロセスは非常に時間がかかる可能性があり、さまざまな評価方法の使用が必要です。しかし、自動機械学習は、多くの時間とエネルギーを節約し、最も正確な予測を提供する自動化されたプロセスによって、機械学習問題に最も適したアルゴリズムを選択します。
モデルチューニング
モデルをチューニングする際、最適なハイパーパラメーターを見つけることは非常に重要であり、モデルの精度に大きな影響を与えます。しかし、最高の精度と最も正確な予測を生み出すハイパーパラメーターは、手動で設定した場合は試行錯誤のプロセスを通じて変更されます。これは当然ながら非常に時間とエネルギーを消費し、手動による評価とプロセスの繰り返しも必要とします。しかし、自動機械学習は、モデルの選択されたアルゴリズムの最適なハイパーパラメーターを自動的に見つけることで、はるかに簡単にします。
モデル評価
機械学習モデルをトレーニングした後は、そのパフォーマンスを評価し検証する必要があります。これは、モデルが新しいデータに対してどのように機能するかを確認し、正確な予測を行うかどうかを判断し、過学習も未学習もないことを確認するために重要です。評価の後、結果が成功した場合にのみ、新しいデータに対するモデルの予測の精度を信頼できます。しかし、自動機械学習はモデルのパフォーマンスと効率を自動的に評価し、機械学習の専門家にとってプロセスをはるかに簡単にします。